Introduction #
Une réorganisation de la collecte des déchets, ça n’a l’air de rien. Et pourtant, dès qu’on baisse la fréquence de collecte sur certains secteurs sans que ce soit homogène à l’échelle d’une commune, il faut être capable de dire à chaque habitant, précisément, quel jour on ramasse chez lui.
Le « jour de collecte », ce n’est d’ailleurs pas une information unique par adresse : chaque flux — ordures ménagères, emballages/papiers, verre, textiles — a son propre jour (ou ses jours) de passage, son propre mode de collecte (porte-à-porte, points d’apports volontaires…) et ses propres consignes de tri. Une adresse peut donc avoir jusqu’à quatre réponses différentes à la question « quand passe-t-on chez moi ? ».
C’est le point de départ de ce billet : comment un besoin de communication assez simple en apparence — « dites-moi mon jour de collecte » — s’est transformé en un petit pipeline SIG (FME, PostgreSQL/PostGIS, flux WFS) construit en interne, du modèle de données jusqu’à la diffusion.
Table des matières #
- La genèse du besoin
- Construire le modèle conceptuel de données
- Le pipeline en pratique
- Deux canaux, deux logiques de développement
- L’agilité comme atout
- Ce qu’il reste à construire
- Conclusion
La genèse du besoin #
Le déclencheur, c’est une réorganisation de la collecte des déchets portée par le service Environnement, avec une baisse de fréquence sur certains secteurs. Le problème, c’est que cette fréquence varie à l’intérieur d’une même commune : le centre d’une commune peut être collecté chaque semaine, un quartier périphérique une fois tous les 15 jours. Une simple affiche « à partir du <date>, la collecte passe à <fréquence> » ne suffit pas — il faut pouvoir répondre « et chez moi, précisément ? ».
Le service Environnement s’était inspiré du gabarit « Grand Public » de GEO, la plateforme SIG de l’éditeur Business Geografic, qui fait tourner le SIG web de Vienne Condrieu Agglomération — sur le modèle d’une cartographie similaire déjà mise en place par Loire Forez Agglomération. Un bon produit, qu’on n’exclut pas de regarder à nouveau un jour selon l’évolution des besoins — mais qui, à ce stade, nous a surtout servi de déclencheur pour clarifier plus précisément la façon dont on voulait restituer un jour de collecte par adresse.
Une fois ce besoin réel reclarifié avec le service Environnement, l’objectif retenu tient en une phrase : permettre à un habitant de retrouver ses jours de collecte via les canaux déjà en place — le site institutionnel, et l’écosystème SIG interne — plutôt que via un outil cartographique supplémentaire et isolé.
Construire le modèle conceptuel de données #
La première étape, avant tout script ou tout job FME, a été de construire le MCD (modèle conceptuel de données) avec le service Environnement : qu’est-ce qu’un « scénario de collecte » ? Quelle granularité ? Quelles informations doit-il porter pour être exploitable par un moteur de recherche par adresse ?
(Parler de « MCD » pour deux tables — les scénarios, et les scénarios croisés par adresse — c’est un peu prendre un bazooka pour écraser une mouche. Mais la démarche compte autant que l’échelle : c’est en posant les bonnes questions sur deux tables qu’on évite d’en regretter dix.)
On a convergé vers une couche polygonale simple :
- un polygone = un secteur × une commune × un flux (ordures ménagères, emballages/papiers, verre, textiles) ;
- pour chaque polygone : mode de collecte, jour(s) de collecte, consignes de tri, lien vers le calendrier.
Concrètement, ça donne cette table, volontairement plate (pas de normalisation en tables séparées pour les flux ou les jours — la volumétrie ne le justifie pas) :
CREATE TABLE environnement.vca_environnement_collecte_scenario (
    gid serial4 NOT NULL, -- PK.
    id_collecte varchar(37) DEFAULT uuid_generate_v4()::character varying(37) NOT NULL, -- ID.
    the_geom public.geometry(polygon, 2154) NULL, -- Géométrie
    code_insee varchar NULL, -- Code INSEE
    type_flux varchar NULL, -- Type de flux
    mode_collecte varchar NULL, -- Mode de collecte
    jour_collecte_01 varchar NULL, -- Jour 01
    jour_collecte_02 varchar NULL, -- Jour 02
    jour_collecte_03 varchar NULL, -- Jour 03
    lien_calendrier varchar NULL, -- Lien vers calendrier
    conteneur_enterre_conseille varchar NULL, -- Conteneur enterré conseillé
    consigne text NULL, -- Consignes
    com text NULL, -- Commentaire
    designation varchar NULL, -- Désignation
    CONSTRAINT vca_environnement_collecte_scenario_pkey PRIMARY KEY (gid)
);
CREATE INDEX vca_environnement_collecte_scenario_the_geom_sidx
    ON environnement.vca_environnement_collecte_scenario USING gist (the_geom);

-- Column comments
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.gid IS 'PK.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.id_collecte IS 'ID.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.the_geom IS 'Géométrie';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.code_insee IS 'Code INSEE';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.type_flux IS 'Type de flux';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.mode_collecte IS 'Mode de collecte';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.jour_collecte_01 IS 'Jour 01';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.jour_collecte_02 IS 'Jour 02';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.jour_collecte_03 IS 'Jour 03';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.lien_calendrier IS 'Lien vers calendrier';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.conteneur_enterre_conseille IS 'Conteneur enterré conseillé';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.consigne IS 'Consignes';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.com IS 'Commentaire';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario.designation IS 'Désignation';
Deux choix simples mais qui font gagner du temps par la suite : jusqu’à
trois jours de collecte en colonnes séparées (jour_collecte_01/02/03)
plutôt qu’un tableau ou une table enfant — ça suffit largement pour le cas
d’usage et ça reste trivial à agréger dans la requête de croisement — et un
index spatial GiST sur the_geom, indispensable dès qu’on va faire un
ST_Contains sur ~32 700 points d’adresse.
Cette couche a été numérisée et est maintenue manuellement par le service Environnement avec le service SIG — pas de bureau d’études extérieur sur cette partie. Elle doit beaucoup à l’expertise métier de la personne porteuse du besoin côté service Environnement, en lien direct avec le prestataire du marché de collecte pour caler précisément les secteurs et les fréquences. Elle est aujourd’hui à un peu moins de 300 entités, inventaire quasiment finalisé à la rédaction de cette note technique.
Le second pilier du modèle, c’est le référentiel adresse : la Base Adresse Nationale, importée via export open data des communes membres. Le croisement des deux — une intersection spatiale simple entre point d’adresse et polygone de scénario — donne, pour chaque adresse, son ou ses scénarios applicables.
Un détail technique de la BAL a directement compliqué ce croisement : dans
bal.vca_bal_adresse, un même numéro de voie peut être porté par plusieurs
points BAL distincts — un par entrée, par bâtiment, voire par
segment de voie — la nuance étant portée par le champ position. Sur
nos ~32 700 points BAL, la répartition est très largement dominée par
entrée (27 265 points), suivie de bâtiment (3 333) et segment
(1 343) ; le reste (parcelle, logement, cage d'escalier, délivrance postale, service technique) reste marginal. Rapporté au couple
numéro/voie/commune, ça donne 32 616 identités d’adresse « textuelles »
uniques pour 32 668 points géométriques — un écart faible en proportion,
mais suffisant pour produire des lignes en double dès qu’on croise chaque
point individuellement avec les scénarios : 47 identités portées par 2
points BAL, une par 3, une par 4. Deux points géométriquement différents
mais rattachés au même numéro/voie, ce n’est déjà pas une adresse
« unique » au sens strict avant même de croiser quoi que ce soit avec les
scénarios de collecte.
Le point le plus intéressant du MCD n’est donc pas le croisement lui-même,
mais la façon de restituer un résultat à une seule ligne par adresse.
Une première version du croisement produisait plusieurs lignes par adresse
— la multiplicité des points BAL par position s’ajoutant à la
multiplicité des flux — jusqu’à 7 lignes pour une seule adresse dans
certains cas. Ça bloquait l’import côté prestataire du site web, qui
attendait une ligne = une adresse. La correction a consisté à pivoter
le résultat : une colonne par flux et par information
(mode_collecte_om, jour_collecte_om, consigne_om,
mode_collecte_verre…), agrégées par STRING_AGG conditionnel — et à
regrouper les points BAL en amont par identité de voie (GROUP BY numero, voie_nom, commune_nom...), la géométrie exposée devenant le centroïde des
points regroupés.
Le pipeline en pratique #
Concrètement, le pipeline s’articule en trois étapes.
graph TB
    subgraph "Sources"
        BAL["Base Adresse Nationale
export open data des communes"]
        SCENARIO["Scénarios de collecte
couche polygonale numérisée
service Environnement + SIG"]
    end

    subgraph "Traitement — PostgreSQL/PostGIS"
        FME["Job FME
import BAL/BAN"]
        ADRESSE[("Table adresses
~30 000 points")]
        CROISEMENT[("Table croisée
1 ligne / adresse
colonnes pivotées par flux")]
    end

    subgraph "Diffusion"
        WFS["Flux WFS GeoServer
GeoJSON"]
        GEO["Recherche GEO interne
module maison"]
    end

    BAL -->|FME| FME --> ADRESSE
    SCENARIO -->|intersection spatiale ST_Contains| CROISEMENT
    ADRESSE -->|intersection spatiale ST_Contains| CROISEMENT
    CROISEMENT --> WFS
    CROISEMENT --> GEO

    style BAL fill:#e3f2fd,stroke:#1976d2,stroke-width:2px,color:#000
    style SCENARIO fill:#e3f2fd,stroke:#1976d2,stroke-width:2px,color:#000
    style FME fill:#fff3e0,stroke:#f57c00,stroke-width:2px,color:#000
    style ADRESSE fill:#c8e6c9,stroke:#388e3c,stroke-width:2px,color:#000
    style CROISEMENT fill:#c8e6c9,stroke:#388e3c,stroke-width:2px,color:#000
    style WFS fill:#f3e5f5,stroke:#7b1fa2,stroke-width:2px,color:#000
    style GEO fill:#f3e5f5,stroke:#7b1fa2,stroke-width:2px,color:#000
- Import BAL via un job FME, avec un paramètre publié permettant de basculer commune par commune sur l’export BAN quand aucun export BAL n’est disponible localement.
- Croisement spatial en SQL/PostGIS, matérialisé dans une table dédiée — c’est la requête pivotée décrite plus haut.
- Diffusion : un flux WFS GeoServer (GeoJSON, projeté en Lambert-93) côté site web, et un accès direct à la table pour la recherche interne.
Pour ne pas rester sur votre faim si vous voulez reproduire le principe
chez vous, voici la requête de croisement dans son intégralité, telle
qu’elle tourne réellement, COMMENT ON compris :
DROP TABLE IF EXISTS environnement.vca_environnement_collecte_scenario_adresse;
CREATE TABLE environnement.vca_environnement_collecte_scenario_adresse AS
SELECT
    ROW_NUMBER() OVER (
        ORDER BY
            a.commune_insee,
            a.numero || COALESCE(NULLIF(UPPER(TRIM(a.suffixe)), ''), '') || ' ' || a.voie_nom || ' ' || c.code_postal || ' ' || a.commune_nom
    ) AS gid,
    uuid_generate_v4()::character varying(37) AS uuid_unique,
    MIN(a.uid_adresse)                          AS uid_adresse,
    MIN(a.cle_interop)                          AS cle_interop,
    ST_Centroid(ST_Union(a.the_geom))           AS the_geom,
    a.numero || COALESCE(NULLIF(UPPER(TRIM(a.suffixe)), ''), '') || ' ' || a.voie_nom || ' ' || c.code_postal || ' ' || a.commune_nom
                                                AS adresse_complete,
    a.commune_nom,
    a.commune_insee::VARCHAR                    AS code_insee,
    c.code_postal,

    -- EMBALLAGES PAPIERS
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'EMBALLAGES PAPIERS' THEN s.mode_collecte END, ' / ')
        AS mode_collecte_emballages_papiers,
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'EMBALLAGES PAPIERS' THEN
        CONCAT_WS(' / ',
            NULLIF(TRIM(s.jour_collecte_01), ''),
            NULLIF(TRIM(s.jour_collecte_02), ''),
            NULLIF(TRIM(s.jour_collecte_03), ''))
    END, ' | ')
        AS jour_collecte_emballages_papiers,
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'EMBALLAGES PAPIERS' THEN s.consigne END, '<br/>')
        AS consigne_emballages_papiers,

    -- ORDURES MÉNAGÈRES
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'ORDURES MÉNAGÈRES' THEN s.mode_collecte END, ' / ')
        AS mode_collecte_om,
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'ORDURES MÉNAGÈRES' THEN
        CONCAT_WS(' / ',
            NULLIF(TRIM(s.jour_collecte_01), ''),
            NULLIF(TRIM(s.jour_collecte_02), ''),
            NULLIF(TRIM(s.jour_collecte_03), ''))
    END, ' | ')
        AS jour_collecte_om,
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'ORDURES MÉNAGÈRES' THEN s.consigne END, '<br/>')
        AS consigne_om,

    -- VERRE
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'VERRE' THEN s.mode_collecte END, ' / ')
        AS mode_collecte_verre,
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'VERRE' THEN s.consigne END, '<br/>')
        AS consigne_verre,

    -- TEXTILES
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'TEXTILES' THEN s.mode_collecte END, ' / ')
        AS mode_collecte_textile,
    STRING_AGG(DISTINCT CASE WHEN s.type_flux = 'TEXTILES' THEN s.consigne END, '<br/>')
        AS consigne_textile,

    MAX(s.lien_calendrier)                      AS lien_calendrier,
    AVG(a.long)                                 AS long,
    AVG(a.lat)                                  AS lat

FROM bal.vca_bal_adresse a
INNER JOIN environnement.vca_environnement_collecte_scenario s
    ON ST_Contains(s.the_geom, a.the_geom)
INNER JOIN cadastre.vca_dgi_commune c
    ON c.insee::VARCHAR = a.commune_insee::VARCHAR
GROUP BY
    a.numero,
    a.suffixe,
    a.voie_nom,
    a.commune_nom,
    a.commune_insee,
    c.code_postal
ORDER BY
    a.commune_insee,
    a.numero || COALESCE(NULLIF(UPPER(TRIM(a.suffixe)), ''), '') || ' ' || a.voie_nom || ' ' || c.code_postal || ' ' || a.commune_nom;

ALTER TABLE environnement.vca_environnement_collecte_scenario_adresse
    ADD PRIMARY KEY (gid);

-- Commentaires
COMMENT ON TABLE environnement.vca_environnement_collecte_scenario_adresse
    IS 'Adresses BAL avec scénarios de collecte pivotés par type de flux.';

COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.gid
    IS 'Clé primaire.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.uuid_unique
    IS 'Clé unique de l''adresse.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.uid_adresse
    IS 'Identifiant unique national d''adresse.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.cle_interop
    IS 'Clé nationale d''interopérabilité.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.the_geom
    IS 'Géométrie du point adresse (Lambert 93).';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.adresse_complete
    IS 'Adresse complète (numéro + suffixe + voie + code postal + commune).';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.commune_nom
    IS 'Nom de la commune.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.code_insee
    IS 'Code INSEE de la commune.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.code_postal
    IS 'Code postal de la commune.';

COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.mode_collecte_emballages_papiers
    IS 'Mode de collecte pour le flux Emballages / Papiers.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.jour_collecte_emballages_papiers
    IS 'Jour(s) de collecte pour le flux Emballages / Papiers (concaténés, séparateur " | " si plusieurs scénarios).';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.consigne_emballages_papiers
    IS 'Consignes de tri pour le flux Emballages / Papiers (HTML, séparateur <br/> si plusieurs scénarios).';

COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.mode_collecte_om
    IS 'Mode de collecte pour le flux Ordures Ménagères.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.jour_collecte_om
    IS 'Jour(s) de collecte pour le flux Ordures Ménagères (concaténés, séparateur " | " si plusieurs scénarios).';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.consigne_om
    IS 'Consignes de tri pour le flux Ordures Ménagères (HTML, séparateur <br/> si plusieurs scénarios).';

COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.mode_collecte_verre
    IS 'Mode de collecte pour le flux Verre.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.consigne_verre
    IS 'Consignes de tri pour le flux Verre (HTML, séparateur <br/> si plusieurs scénarios).';

COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.mode_collecte_textile
    IS 'Mode de collecte pour le flux Textiles.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.consigne_textile
    IS 'Consignes de tri pour le flux Textiles (HTML, séparateur <br/> si plusieurs scénarios).';

COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.lien_calendrier
    IS 'Lien vers le calendrier de collecte de la commune.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.long
    IS 'Longitude WGS84 de l''adresse BAL.';
COMMENT ON COLUMN environnement.vca_environnement_collecte_scenario_adresse.lat
    IS 'Latitude WGS84 de l''adresse BAL.';
Le mécanisme tient en deux idées : un INNER JOIN ... ON ST_Contains(...)
pour rattacher chaque point d’adresse à son (ou ses) polygone(s) de
scénario, et un STRING_AGG(DISTINCT CASE WHEN type_flux = '...' THEN ... END, séparateur) par flux pour transformer des lignes en colonnes. C’est
la même logique qu’un PIVOT/CROSSTAB, écrite à la main pour rester
lisible sans extension supplémentaire.
INNER JOIN exclut silencieusement toute adresse hors
de tout polygone de scénario. Sur un premier jet, préférez un LEFT JOIN
avec un indicateur explicite (sans_scenario) pour repérer les trous de
couverture avant de basculer en production.
Rien d’exotique techniquement — PostGIS sait faire une intersection spatiale et un pivot depuis longtemps. Ce qui a demandé du temps, c’est la convergence sur le bon modèle avec les parties prenantes, pas la mécanique SQL.
Deux canaux, deux logiques de développement #
C’est le point qui illustre le mieux la différence entre les deux moitiés du projet.
Côté site institutionnel, la donnée est consommée par un moteur de recherche développé par le prestataire CMS du site web, à partir du flux WFS qu’on expose. On sait quoi on leur donne (le schéma de la table, le flux GeoJSON), mais on ne sait pas précisément comment leur moteur indexe et restitue la donnée côté front — c’est une boîte noire de leur côté, avec laquelle on échange par specs et retours d’anomalie.
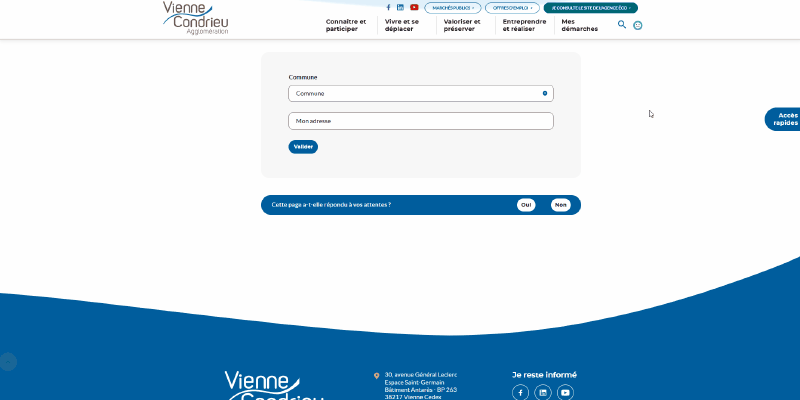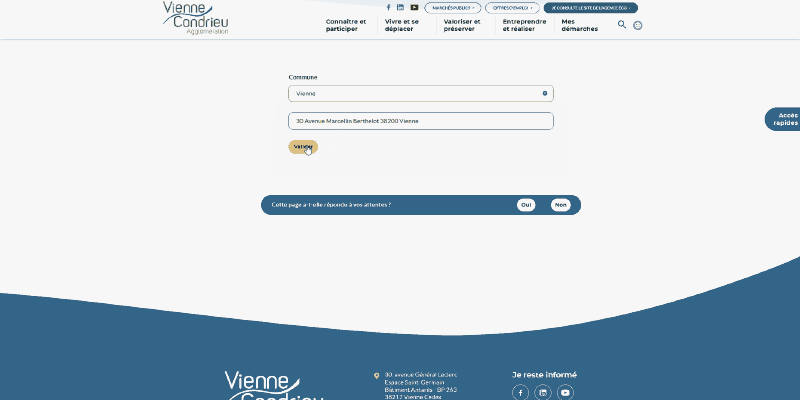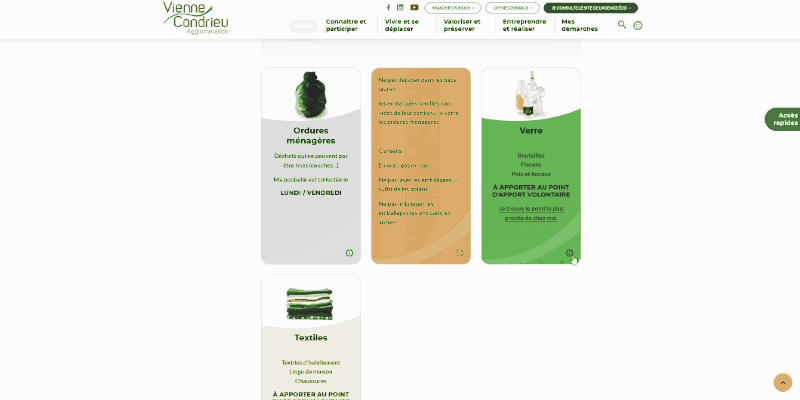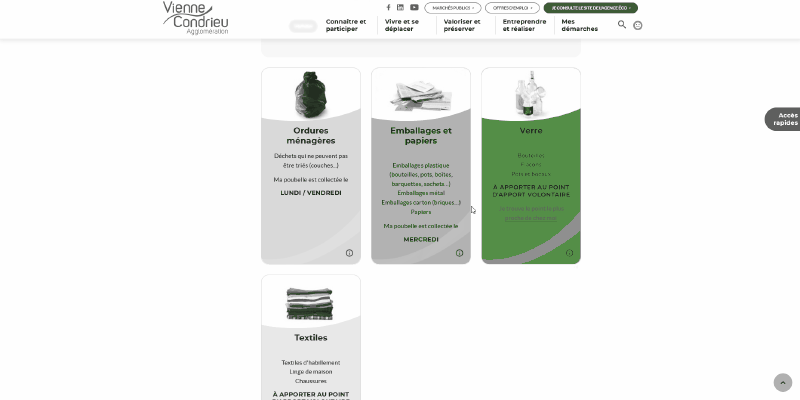
Côté écosystème SIG interne, un module — geo-garbage-collector — a
été développé en interne pour interroger directement la même table de
croisement, sans dépendre du prestataire. C’est le module qu’on maîtrise de
bout en bout : le schéma de données, la logique de recherche, les
évolutions.
geo-garbage-collector, développé en interne, interroge directement la table pivotée dans l’écosystème GEO.L’agilité comme atout #
Maîtriser le pipeline de bout en bout — modèle de données, requête SQL, diffusion — a permis d’absorber plusieurs ajustements en cours de route sans dépendance externe pour les faire évoluer. Deux exemples concrets :
- Le problème des lignes multiples par adresse, remonté par le prestataire CMS après mise en production. La correction (passage au pivot une-ligne-par-adresse) a été un cycle de développement interne classique, mené au rythme du retour utilisateur.
- Un problème d’indexation côté prestataire lié au volume (~30 000 fiches indexées en une seule passe, saturant la mémoire du serveur d’indexation) : identifié, communiqué, suivi — sans qu’on ait à toucher à notre pipeline, juste à documenter et attendre le correctif côté indexation par lots.
L’agilité, ici, ce n’est pas « aller vite » au sens startup du terme. C’est pouvoir itérer sur le modèle de données et la requête au rythme des retours utilisateurs et des retours du prestataire, sans cycle de release externe à attendre pour chaque ajustement structurel.
Ce qu’il reste à construire #
Tout n’est pas terminé, et c’est normal pour un projet qui vit encore. Les points identifiés à ce stade :
- Couverture spatiale non tracée : une adresse hors polygone de
scénario est aujourd’hui silencieusement exclue du résultat — un
LEFT JOINavec indicateur explicite et un rapport de couverture par commune sont prévus. - Pas de contrôle qualité outillé sur la couche des scénarios (recouvrements de polygones, trous de couverture) — de la saisie manuelle sans filet automatique pour l’instant.
- Rafraîchissement manuel du pipeline (FME + SQL), sans orchestration ni alerte en cas d’échec, alors que le flux est déjà consommé en production. À terme, l’étape FME (import BAL/BAN) pourrait être remplacée par un script Linux autonome, plus facile à orchestrer et à planifier qu’un job FME — à voir selon la charge que ça représente face au bénéfice réel.
- Pas de test de non-régression sur le volume de lignes ni l’absence de doublons par adresse — le seul filet de sécurité à ce jour a été un signalement manuel du prestataire.
- Point d’apport volontaire et borne textile les plus proches : compléter la restitution par adresse avec le point d’apport volontaire le plus proche, et de même pour les bornes de collecte de textile — les deux couches sont déjà présentes et à jour sous GEO, en base PostgreSQL/PostGIS, il ne reste qu’à brancher un calcul de proximité dessus.
Conclusion #
Ce qu’on en retient :
- Clarifier le besoin réel de restitution avant de choisir un outil ou une méthode — même un bon produit générique peut ne pas correspondre à un besoin très spécifique.
- Le temps investi dans le MCD (granularité du scénario, pivot une-ligne-par-adresse) a plus payé que n’importe quelle optimisation SQL.
- Développer le module de recherche interne en parallèle du canal prestataire donne un filet de sécurité et une maîtrise complète d’au moins un des deux canaux.
Image de couverture : Pawel Czerwinski sur Unsplash.